测试只能抽查输入,证明要覆盖规定范围内的所有输入。Anthropic 与 Theorem 把写证明的工作交给 Claude,由检查程序 Rocq 逐步核对。结果是 239 个入口的不崩溃证明,附带一组前提:特定编译版本、输入上限、内存预算,以及对芯片和操作系统的数学描述。
2026-10-22,Anthropic 公布了与初创公司 Theorem 合作的软件验证研究。测试把输入交给程序运行,观察是否出错。这项研究尝试用数学证明,说明在规定条件下,不存在会让程序崩溃的输入。Claude 负责写证明,独立检查程序负责核对推理。
研究的出发点是:大多数软件里都有大量 bug,AI 现在已经能轻松找到并利用它们,常规的防御手段不再够用。原文举的例子是 Linux 内核。它是当今测试最充分的软件之一,部署在全球数十亿台设备上,最近仍被披露了超过 1,000 个漏洞。原文因此主张,需要有办法证明代码中没有 bug。
研究在几周内,为 123 个开源库的 239 个测试入口完成了证明。入口是项目作者为测试提供的输入通道。这份保证有前提:输入大小和运行内存受到限制,证明只针对特定版本,还依赖对机器和操作系统行为的准确描述。不崩溃,也不等于没有其他 bug。
在尝试证明某个库不会崩溃时,Claude 发现了它自带解压器中的计数错误。输入约 20 MB,而且内容必须按一种罕见方式排列,才会让程序写到不该写的内存。原文说,这批库都在 Google 的 OSS-Fuzz 项目里接受持续测试,Claude 写证明时发现的 bug 有些躲过了多年检测。
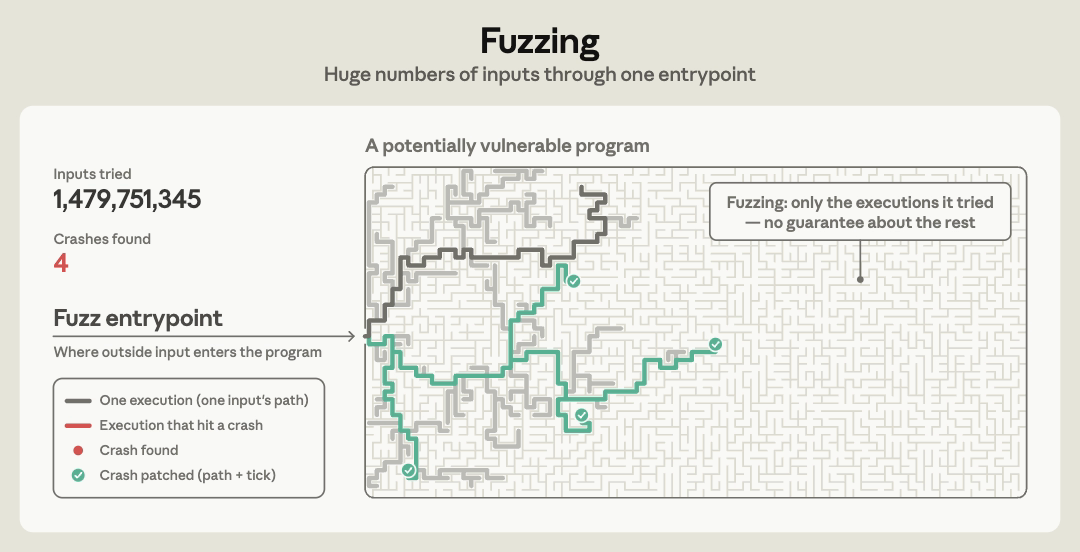
随机输入测试(fuzzing)会自动生成、修改大量输入,寻找触发错误的情况。研究原文指出,这类测试通常处理较小输入,上限通常为 1 MB,并依靠代码覆盖来引导搜索:观察哪些代码已经执行过,再据此调整输入。解压器的问题既需要较大的输入,又需要特殊布局,因此原文认为随机输入测试不太可能碰到它。继续运行测试可以找到更多问题,却不能保证走过所有可能的执行路径。
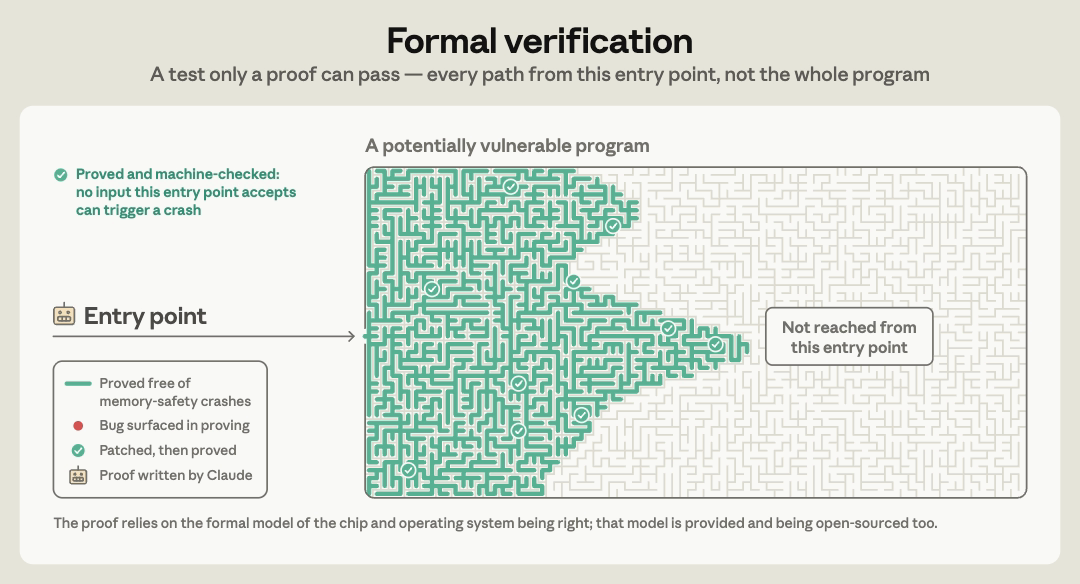
形式化验证采用另一种方法。先把程序如何执行写成数学描述,再推导它是否始终满足选定要求。证明可以用一般性的推理覆盖要求范围内的所有输入,不必把每个输入都实际运行一遍。这里覆盖的是预先选定的规则,不是程序所有可能的正确性要求。
原文用两段动画把这个区别画在同一座迷宫里。随机输入测试在迷宫里一条一条地走,在走过的路上找到并修补了几个崩溃点,没走过的地方没有任何保证。证明则把从这个入口能走到的区域全部铺满;入口走不到的部分,图里仍然空着。


尝试证明也可能失败。失败不等于程序必有 bug,但推理受阻的位置可能暴露违反要求的情况,帮助研究人员找到问题。这次解压器的错误就是在这样的过程中出现的。
过去,这种方法需要大量专家工作。seL4 操作系统内核的实现用了两人年,形式化验证则用了 20 人年。人年衡量的是工作量,不是项目实际持续了多少年。这次研究把写证明的工作交给 Claude,尝试在更多已有软件上完成验证。
要证明一个程序正确,先得说清什么叫正确。有些程序有现成标准可依:PNG 解码器按 RFC 2083 把一串字节解成对应的图像。大多数程序没有这么明确的标准。原文提出的问题是:一个文本编辑器或网页浏览器怎样才算“正确”?原文认为,很难得到完整、没有歧义的要求,是大规模验证软件的一大障碍。
这项研究的办法是不另写要求。它把确定要求、生成证明和检查证明分开处理,要证明的目标从项目已经存在的测试生成。
这些测试来自 Google 的 OSS-Fuzz 项目,入口由项目开发者编写。研究人员把库和测试一起编译,得到机器可以执行的文件。再结合程序执行的数学规则,以及“不会崩溃”这一要求,机械生成需要证明的要求。
这里的数学规则描述机器指令和操作系统怎样执行程序。它们让“这个测试不会崩溃”不再只是一句自然语言,而成为能够逐步推理、逐步检查的要求。
Claude 随后为这个要求写证明。它需要推导:在规定输入范围和运行条件内,执行不会走到被定义为错误的位置。写出证明还不算完成,证明必须交给 Rocq。Rocq 是逐步核对推理的检查程序,核对不通过,结果就不算数。因此,证明是否成立并不依靠 Claude 自己宣称成功。原文说,这些证明的总量虽然庞大,几乎都不需要人工审阅。
原文还解释了为什么过去做不到。这类要求的证明,要覆盖数万条汇编指令在任意输入下的所有行为和相互作用,写出来往往极其庞大,过去几乎无法完成。为一个定义清楚的目标逐行处理数百万行代码,正是今天的大模型非常擅长的工作。
几周内,团队完成了 123 个库的 239 个入口的证明。其中一些程序先暴露了 bug,Claude 修复后才继续证明。根据原有测试机械生成要求是基本流程;允许修补程序,则是要求会随代码改变的例外。
整个证明尝试找到了数百个 bug。除了开头的解压器问题,还有一个库中用于限制应用加载文件的功能,有时并没有生效。这属于逻辑错误,即使程序没有崩溃,也可能没有按预期工作。
| bug | 触发条件 | 类型 |
|---|---|---|
| 解压器计数器下溢 → 越界写 | 约 20 MB、且有一种罕见特定布局的输入 | 内存错误 |
| 图像解码器越界读 | 64 MB 输入,并消耗超过 2 GB 内存 | 内存错误 |
| 另一个库的越界读 | 对同一文件的两个句柄按特定顺序调用 | 内存错误 |
| libexpat CVE-2026-56132 | 深度嵌套的输入 | 已知漏洞,此次重新发现 |
| 限制应用可加载哪些文件的功能,并非总是生效 | 在证明该库内存安全时注意到 | 逻辑 bug,不会崩溃 |
五个例子均来自原文。原文说,随机输入测试通常变异 1 MB 以内的小输入、靠代码覆盖引导,这次找到的 bug 里有很多是它不太可能找到的;「数百个 bug」原文没有给精确计数。
Anthropic 因此把发现问题看作证明过程本身的一项成果。即使某个入口最终没有完成证明,尝试推导的过程仍可能找到需要修复的真问题。完成安全证明和在途中找到 bug,是相关但不同的结果。
发现 bug 后,Claude 可以修改代码,再根据改后的程序重新生成要求,继续证明。这避免了每次发现问题都必须停下来等待人工处理,但也留下了模型钻空子的可能:如果把程序改成什么也不做,“不会崩溃”就容易证明,原本要完成的功能却没有保住。
为减少这类取巧,团队对任何补丁都扣分;如果 Claude 能证明补丁改变了哪些输入上的行为,而且这样的输入很少,就能获得额外加分。团队还记录并审计补丁,检查是否出现技术上满足目标、实际不符合原意的捷径。
这份证明覆盖小于 64 MB 的输入,同时要求程序运行时不超出设定的内存预算。在指定版本、指定入口和机器运行假设下,它排除了规定范围内的错误。
主研究用 AddressSanitizer(ASan)作为内存错误检测口径。它给程序加上检查,遇到能够检测的内存错误,比如访问了不该访问的内存,就报错停下。因此,证明这些检查不会报错,确实排除了一类重要错误,但不能扩大成所有内存错误都不存在。
保证首先受检查内容的范围约束。程序不崩溃,不代表结果一定算对,也不排除检测工具抓不到的错误或内存泄漏。证明只涉及从该入口能够执行到的代码,入口触及不到的代码不在保证内,因此不能代表整个库。原文还提到,即使验证了一个库的全部入口,也不能覆盖整个库,尤其在存在死代码时;实际程序还可能用错这个库,在调用方造成内存破坏。要堵上这个缺口,需要为每个公开函数写明调用方必须做到什么,调用方也得严格照做。
如果原有测试已经检查某个功能性质,情况会不同。程序员可以写入断言,也就是条件不满足就中止的检查。如果这项检查实际编入程序,而证明排除了它触发中止的可能,那么它检查的性质也在覆盖范围内获得了证明。附录举的例子是 LZO 压缩库:它的测试先压缩输入,再解压结果,断言两步都成功,并且解压出的字节数与原来相同。要证明这些断言在任何输入下都不会触发,Claude 必须证明压缩器与解压器能够正确往返。这是一个关于库“算出了什么”的命题,不只是关于它往哪里写内存。所以,“不崩溃”并不总是只说明程序没有访问错误的内存,具体还取决于测试检查了什么。
// LZO 压缩测试(附录第 6 页)
r = lzo1x_1_compress(data, size, compressed, &compressed_len, wrkmem);
assert(r == LZO_E_OK);
if (compressed_len >= size) goto join;
decompressed_len = size + 1;
r = lzo1x_decompress(compressed, compressed_len, decompressed, &decompressed_len, NULL);
assert(r == LZO_E_OK && decompressed_len == size);测试只断言两步成功、字节数相同;「压缩与解压正确往返」是证明这两条断言不会触发时必须推出的结论。
保证还受编译版本约束。主研究针对在 Linux 上运行、使用 RISC-V 的单线程特定构建,RISC-V 是一种芯片指令集。很多实际部署使用 x86 或 ARM,不能把这份文件上的证明直接外推到那些版本。证明针对编译后可执行的文件,不是对源代码及其所有构建方式作统一保证。
此外,不崩溃不等于一定结束。博客开头称程序总会正常退出,但公开证明仓 README 明确写明,本次发布没有证明程序一定会停下;本文按这一较明确的说明处理,不排除永不结束的运行。
最后,证明依赖机器与操作系统的数学描述准确、要证明的要求合适、检查程序正确。Rocq 能检查推理是否满足要求,却不能判断要求是否与现实相符。Anthropic 在原文中明确区分了这两件事:经过形式化验证,不等于没有 bug。
“Formally verified” does not mean “bug-free.”Anthropic · 原文局限一节
需要信任的三样东西(原文列出)
原文的意思是,剩下的 bug 要么藏在这几样被信任的组件里,要么在证明范围之外。把 Rocq 以及 RISC-V 和 Linux 的数学描述核实可靠并非小事,但比逐行调试证明覆盖的全部代码好办得多;而且这种做法可以保护任意多个项目,被信任的部分却不会随之变大。
这次研究累计生成约 10 亿行证明相关内容,其中约 1.8 亿行成为通过检查的证明的一部分。它们并非全部由 Claude 逐字写出,许多内容由工具和脚本生成。对一份证明运行检查,需要 30 分钟到几个小时的 CPU 时间。原文自己把成本列为这类方法的关键局限之一:这类证明可能要消耗数亿 token 才能写出,要让这些方法惠及整个软件生态,成本效率至关重要。
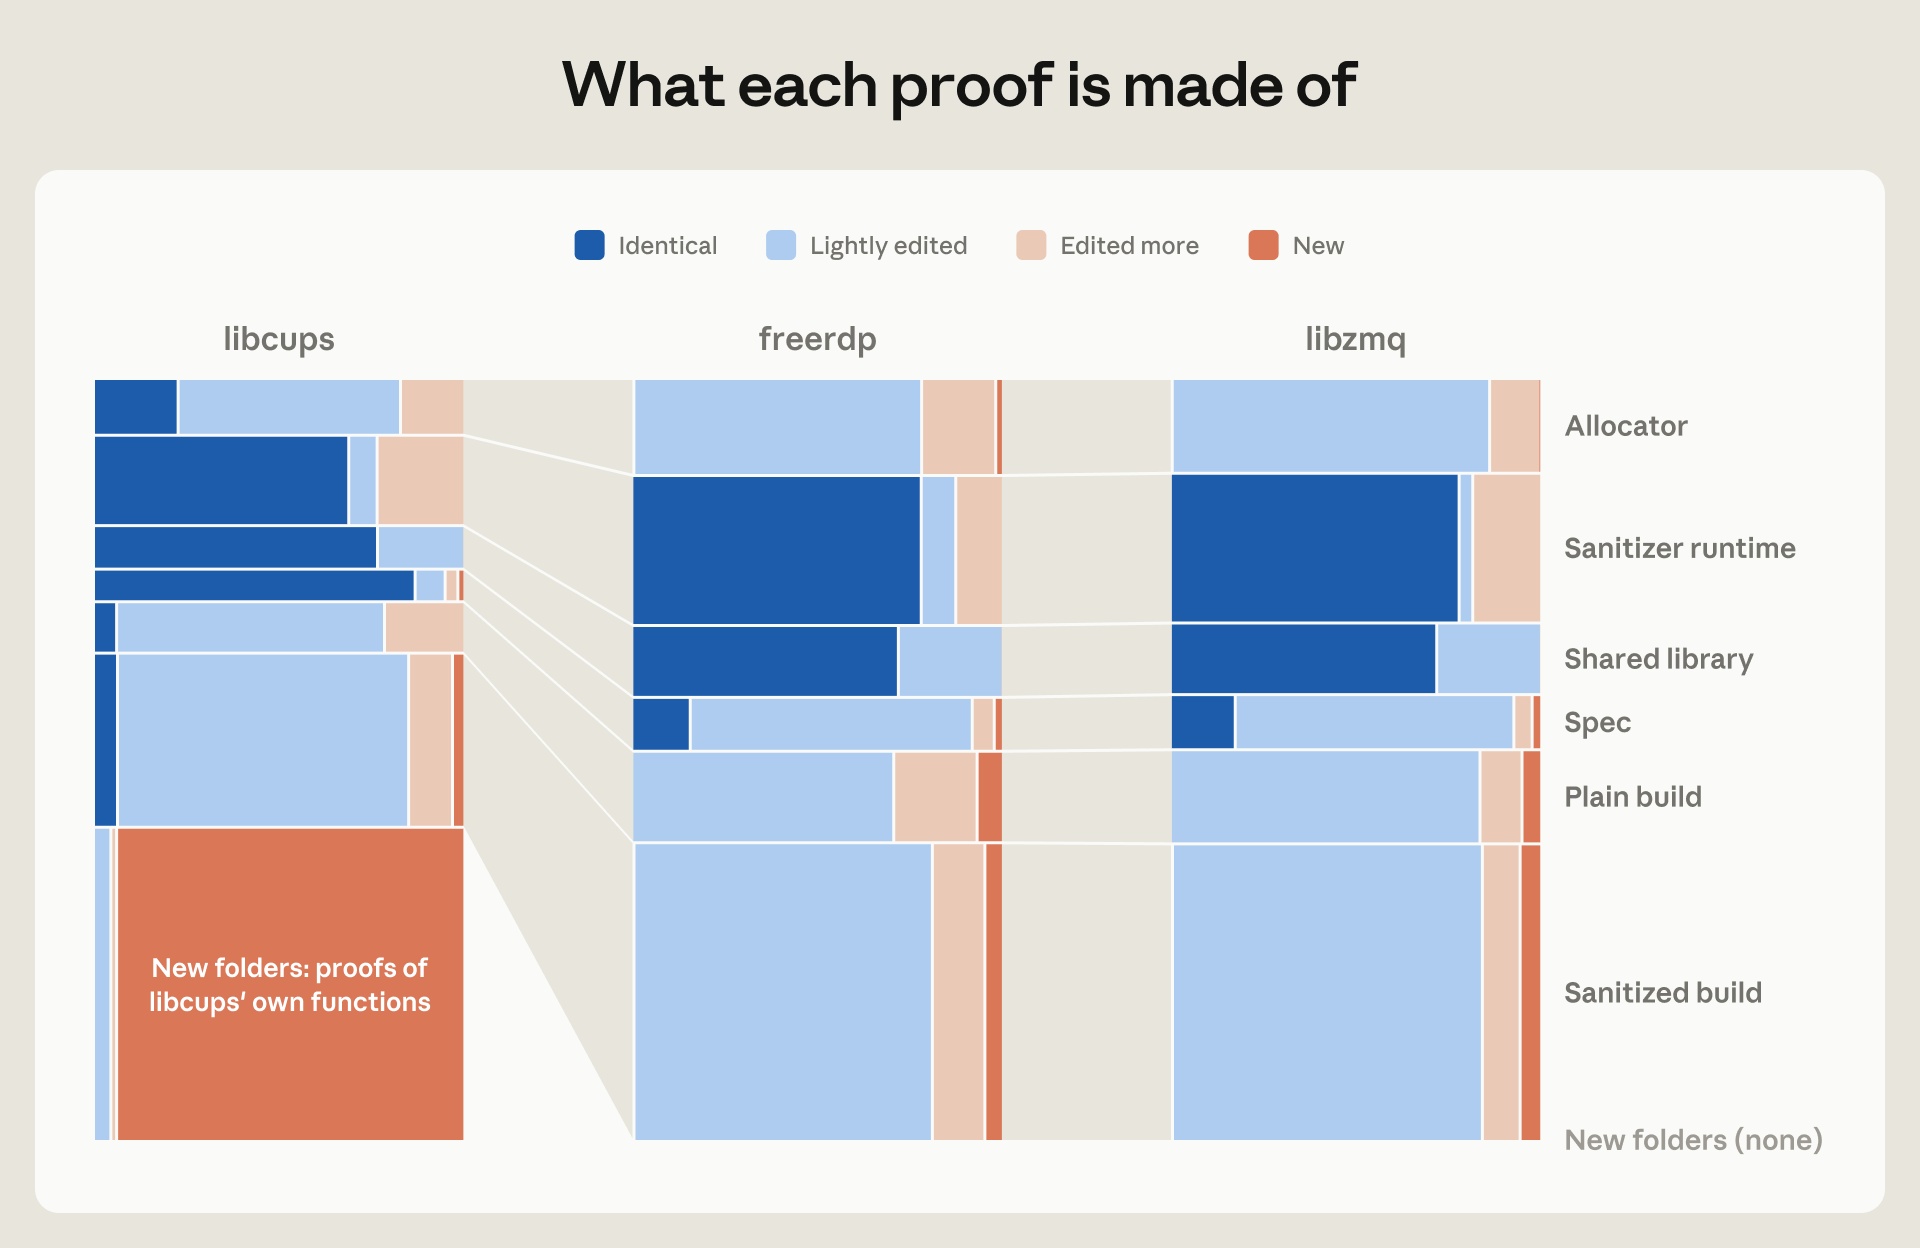
证明之所以长,是因为它要覆盖整个程序进程。不仅有库本身,还有启动过程、公共依赖和检测工具的运行部分。不同库都带着这些公共部分,因此较小的库也可能需要很长的证明。复制并修改已有证明可以减少重复劳动,但这次研究中的每份证明仍需包含公共部分,尚不能把它们直接作为已证明模块导入。

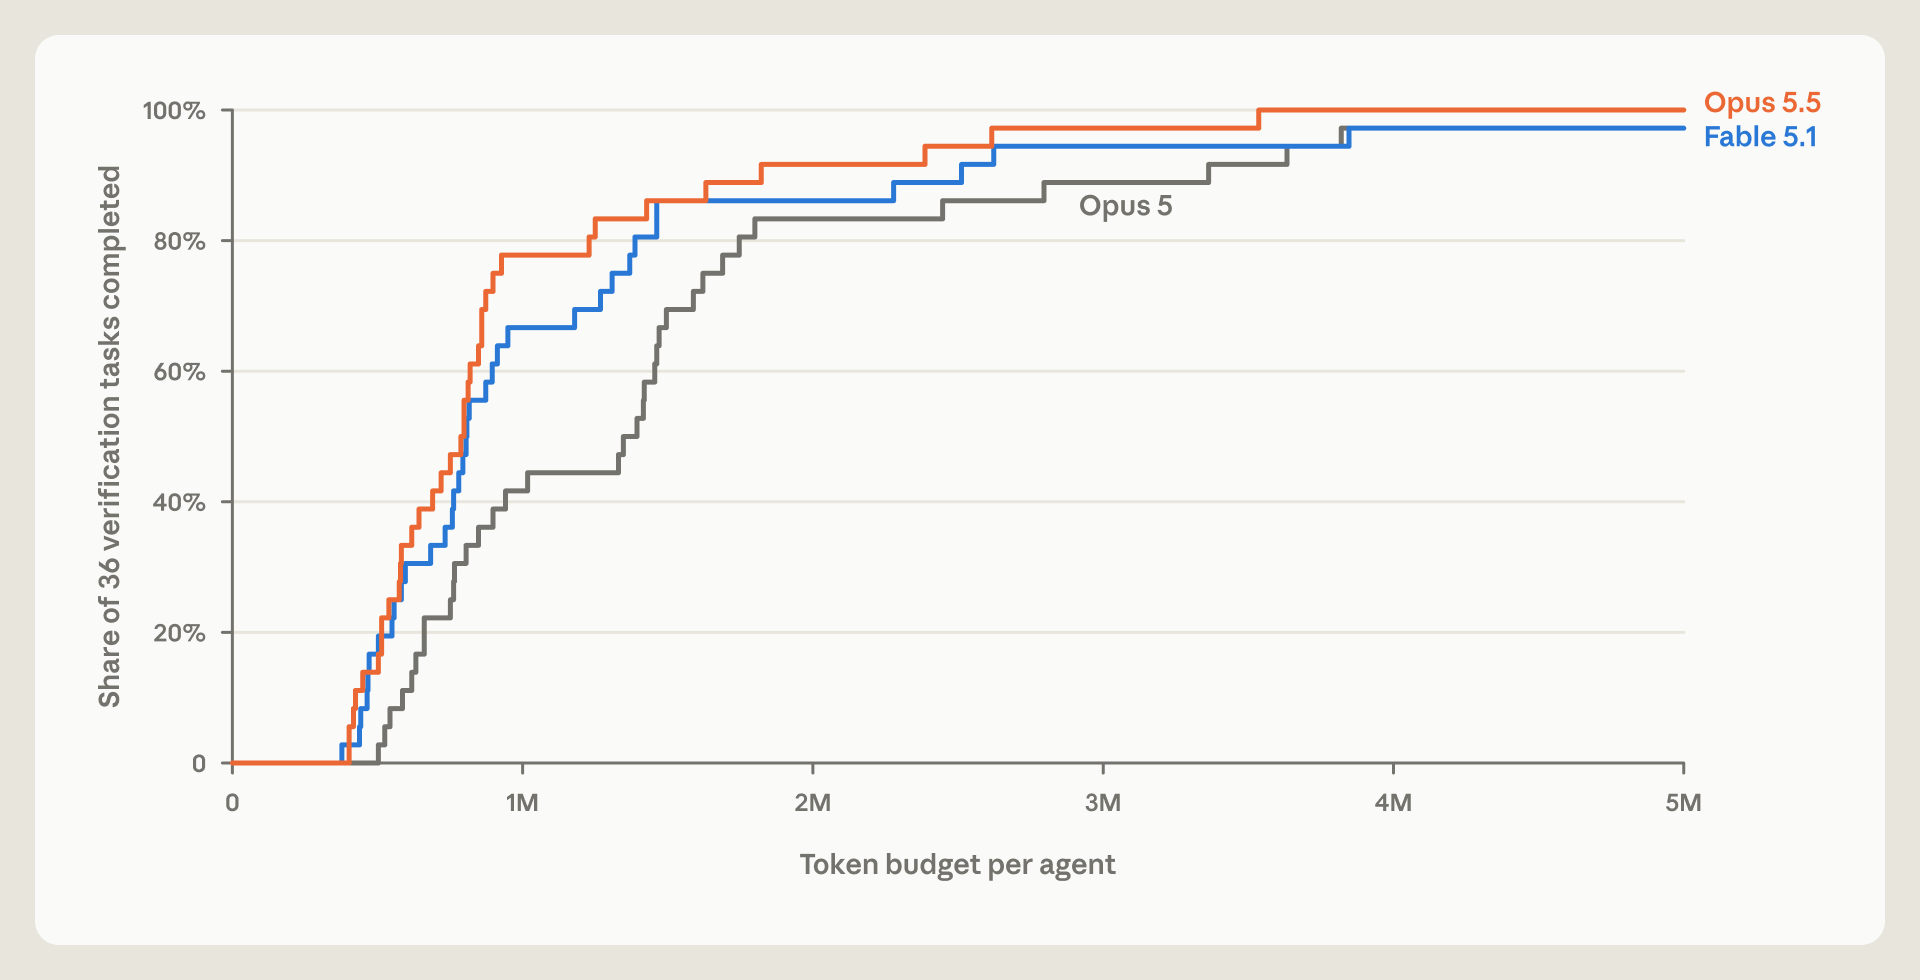
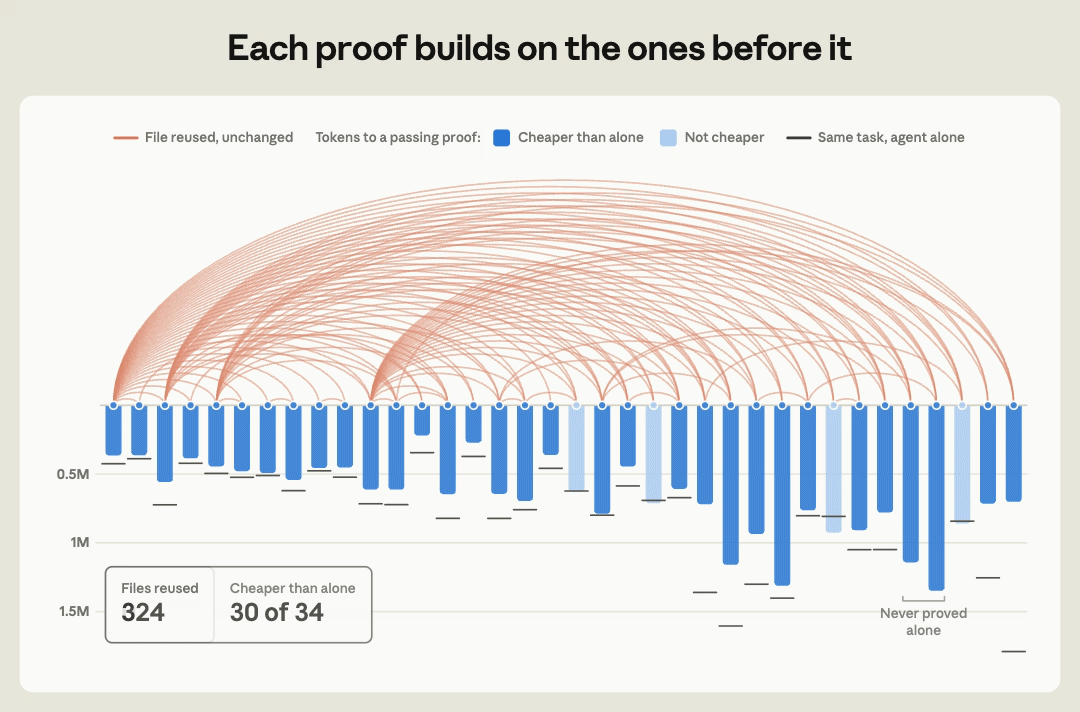
团队用同一组 36 个缩小版任务考察了提高效率的两种方式。完成其中一半任务的证明时,Opus 5.5 所需 token 比 Opus 5 少约 40%;允许共享证明时,所需 token 比单独工作少 17%。token 是模型处理和生成文本的计量单位,减少 token 不直接等于减少同样比例的费用或运行时间。


这些任务来自真实代码,但为了实验而缩小了输入、替换了公共库,并使用简化的内存检查工具。两个节省数字只适用于这组小任务,不能当作完整真实项目的节省幅度。团队也在实际研究中观察到了证明复用,但没有据此把少 17% token 的结果外推过去。
附录中的形式化验证专家指出,agent 写的证明非常冗长,会反复写出寄存器内容、地址互不相同这类细节,人类证明工程师则会立刻引入抽象把重复部分提取出来。冗长不等于证明不正确,它们同样证明了定理。但这种写法能否直接扩展到更复杂的程序,还有待观察;附录提到,MachCSL 等其他用 agent 做验证的项目的经验提示,答案可能是否定的:在那些项目里,agent 用冗长写法撞上了复杂度墙,要继续扩大规模,证明需要围绕更好的模块化抽象和推理原则来组织。模型已经能写出通过检查的证明,但要让这种验证成为日常开发工作的一部分,仍有成本和扩展性问题要解决。
博客报告的是 123 个库的 239 个入口;归档的公开证明仓 v2026.10.0 则包含 25 个库的 60 个入口。Anthropic 写明了两条发布规则:发布不需要补丁的证明,不公开可能暴露未修 bug 的证明。但博客和 README 没有逐项交代数量差额,不能把所有差额都归结为这两条规则。
239 与 60 的差额,原文和 README 都没有逐项说明来由;两条发布规则能解释公开数为什么更少,但不能把全部差额都归给它们。
莱斯大学研究计算机安全的教授 Dan Wallach 肯定了这项工作的自动化程度,以及它在长期接受测试的库中仍然找到 bug 的成果。在他看来,作为一次性的排错行动,这种方法有价值;对航电、医疗电子等认证要求较高的软件,这样的投入也很值得。
他的担忧集中在后续维护。代码、依赖或编译器发生变化,证明可能需要修补,甚至从头生成。他认为这会带来缓慢而昂贵的工作,难以进入每次构建都运行的持续集成与交付流程。
Wallach 建议,把证明过程中得到的函数使用条件和结果保证写回源代码,再配合验证工具维护。他同时认为,仍有必要把证明做到机器码这一层,并没有主张放弃这一层保证。
Anthropic 的预期是,随着模型能力、语言设计和开发流程继续进步,形式化验证很快会对几乎所有生产软件变得像今天的随机输入测试一样实用;就像静态类型和测试框架一样,验证会从“外挂”变成“内建”。这仍是对未来的判断。目前做到的是:在明确条件下,为一批真实开源软件写出并检查了证明。
As a one-time bug-finding expedition, it’s certainly valuable.Dan Wallach(莱斯大学)· Mastodon · 2026-10-23
主研究的对象是单线程、静态链接的 RISC-V/Linux 二进制文件。静态链接是把程序依赖的库代码一起编入同一个可执行文件;这里使用 musl,而不是许多日常部署采用的 glibc。公开仓记录的构建工具是 clang 20.1.8,证明检查使用 Rocq 9.2.0。证明针对这些具体文件,不会自动覆盖其他编译结果。
每个入口有不带检测工具的普通版,以及加入 ASan 的版本。附录列出了需要证明的三条要求:ASan 版不崩溃,普通版与 ASan 版行为等价,普通版自身也不崩溃。这些要求针对小于 64 MiB 的输入,并覆盖所有内存布局;博客正文将输入上限写作 64 MB,本文正文沿用博客写法。
这里的“行为等价”只比较规定的外部可观察结果,不要求程序执行的每一步都一样。附录列出的观测项是:
比较还要求读写事件的顺序相同。这个定义不包含性能。一次崩溃可能让读写记录停住,无声的无限循环也可能如此,因此行为等价本身不足以排除普通版崩溃,必须另证普通版不崩溃。
公开仓还包含部分入口的 UndefinedBehaviorSanitizer(UBSan)证明,它用于检测某些未定义行为,不能把这些结果扩大到主研究全部入口。普通版的内存预算,在 ASan 相关陈述中为 2 GiB,在 UBSan 陈述中为 16 GiB。普通版超出预算的输入不在保证内。
这些要求在 LPS 中表达。LPS 是 Linux 进程运行 RISC-V 文件的数学模型,README 明说它不完整,也包含未自行检查的假设。模型与实际 Linux 不同的地方,可能使证明不适用。博客列出的信任前提之外,还需信任检查程序所依赖的硬件、操作系统和 OCaml 编译器。
项目早期,模型为证明两个版本输出一致,通常先归纳一个更短的中间规格,再证明两个版本都满足它。这些中间规格的中位长度约 110 行,程序代码大小的中位数是 86 KB,证明覆盖了其中由测试入口执行到的约 20–50%。这是证明过程中组织推理的方式,不是允许模型自由改变研究最终目标。
除正文中的解压器案例外,还有一个库在通过同一文件的两个句柄、按特定顺序调用时,会读取不该读取的内存。文件句柄是程序用来访问已打开文件的标识。Claude 还发现了一个图像解码器的越界读取,需要 64 MB 输入并消耗超过 2 GB 内存才会触发;它重新发现了 libexpat 中的 CVE-2026-56132,触发条件是深度嵌套的输入。另一个库限制应用能够加载哪些文件的功能并非总被执行,这是不会引发崩溃的逻辑 bug。发现它不等于“不崩溃”要求已经证明这项访问限制正确。
正文第 4 节的 LZO 例子还有两处细节。一是测试代码只断言两步成功、字节数相同,没有直接用断言逐字比较内容;“压缩器与解压器正确往返”是附录作者对证明所需推理的说明,不能据此写成“代码直接检查了内容完全一致”。二是在二进制里,每条断言都是一个跳到中止处理的分支,证明在这些分支的确切地址上逐个推演,表明它们永远不会被走到。
p11-kit 管理对智能卡和加密硬件的访问。它的配置解析代码在识别 PEM 数据块时,通过断言检查数据块不会超出输入缓冲区的范围,证明也覆盖了这项检查。cpp-httplib 的案例则需要排除递归过深撑爆调用栈:Claude 为此证明 libc++ 的红黑树重新平衡算法能够保持对数级深度。红黑树是一种树状数据结构,这里对树深度的约束用于排除相关递归过深造成的栈溢出。
另一项实验不是从“不崩溃”出发。团队让 Claude 为定义 zlib 压缩文件格式的 RFC 1950 写出要求,再证明 Linux 内核中的 zlib 实现符合它。对象是 x86 二进制文件,所用的指令执行语义由 Claude 生成并经过大量测试。团队把过程扩展到约六个其他常用库,发现了一些不可利用的小 bug,正在向上游报告。原文从中得出两点:这些测试极其充分的代码库本来就已经几乎完全正确;对真实存在的代码库证明端到端的正确性是做得到的。
关于这套 x86 语义,原文称,逐步按其执行规则运行能够启动 Linux 内核上的 Ubuntu 用户空间;生成语义时还发现了官方参考文档中的数百处错误,以及较少量的硬件 bug。作者同时说明,经验测试不能保证语义本身完美。
Python 实验让 Claude 用 Rust 编写一个支持 Python 较大子集的解释器,并用适合 Rust 的验证工具 Verus 检查。它实现了 17 层,证明的要求是:只要解释器返回结果,结果就符合选定的数学语义。这并不保证程序终止,也不等于已经证明与 CPython 完全等价。
团队另外运行超过 170 万个随机程序,其中 99.95% 的行为与 CPython 一致,其余差异是已知边界情况。这个一致性结果来自测试。为了比较测试和证明,团队在早期版本注入 7 个 bug,其中 5 个躲过随机测试,7 个全让证明失败。
原文还报告,在一个未点名的关键应用中发现了存在十多年的逻辑 bug;验证一个未点名的常用 PDF 阅读器时,一周发现的安全 bug 数量,相当于通常一年报告的数量。
完整程序的证明要覆盖公共运行部分,因此证明规模与库自身大小并不成简单的比例关系。典型入口背后的库代码编译后约有 2,000 条指令,完整二进制的指令数中位数则约为 18,000 条,两者不是同一个统计口径。附录用 cJSON 和 fftw3 展示了这种差别。
| 项目 | 归档源中的数据 |
|---|---|
| 项目累计生成 | 约 10 亿行 |
| 成为通过检查的证明的一部分 | 约 1.8 亿行 |
| 典型的已完成证明 | 约 60 万行,约 1,400 个文件 |
| 不同库的证明范围 | 约 33 万到 90 万行 |
| cJSON | 391 行入口,63 万行证明,约十分之一与 cJSON 有关 |
| fftw3 | 链接 51,000 行,48 万行证明 |
| 工具自动生成部分 | 过半由工具生成 |
| 证明正文部分 | 约 40%,其中也有脚本生成 |
| 一份证明的检查 | 30 分钟到几个小时 CPU 时间 |
| 公开仓检查资源 | 16 核时最高 20 GiB 内存 |
自动生成部分包括指令编码和查找表;证明正文包括定义、机器模型及推理步骤。当前每份证明仍须包含公共部分的证明,复制改写不等于已经能够模块化直接导入。附录专家观察到,一些 agent 使用了抽象,将重复细节整理成统一规则,但这与证明长度减少只有较弱关联,不能据此说抽象已经解决成本问题。
效率实验来自同一组 36 个缩小版任务。团队保留程序核心,简化 libc,限制输入,并用 mini-ASan 替换完整检测工具。mini-ASan 是简化后的内存检查实现。它和完整 ASan 运行时执行一次内存检查所需的指令数不同。
| 实验项目 | 设置或结果 |
|---|---|
| 输入上限 | 64 字节 |
| mini-ASan 每次内存检查 | 约 100 条指令 |
| 真实 ASan 运行部分 | 超过 100,000 条指令 |
| 缩小后程序 | 283–2,491 条指令 |
| 单独工作设置 | 每个任务有三次单 agent 独立尝试,每次 500 万 token,首次成功即记为完成证明 |
| 模型比较 | 完成一半任务的证明,Opus 5.5 比 Opus 5 少用约 40% 的 token |
| 共享工作区比较 | 使用共享工作区时,比单独工作少用 17% 的 token |
| 已完成证明 | 34 个完成,其中 30 个低于单干平均成本,两个证明在单干时未完成 |
真实 OSS-Fuzz 工作中也观察到团队复制已有证明,再适配不同程序;原文没有给出这些真实任务对应的整体节省幅度。
公开仓 v2026.10.0 的统计包含不同层级。它为 1,381 个 OSS-Fuzz 项目建立目录,其中 427 个能构建;5,290 个测试中,2,148 个有陈述。一个入口可以产生不同编译版本和不同种类的陈述,陈述数不等于入口数,也不等于库数。
该版本共有 20,164 条陈述:138 已证,229 形式模型未覆盖而卡住,19,797 未解决,0 已知为假。138 统计的是已证陈述,对应有证明的 60 个入口、25 个库。229 条受阻的原因是 LPS 尚未描述需要的系统功能,不是这里已经测得 AI 证明能力不足;0 已知为假也不是其余要求都已获证明。
Anthropic 公布了 RISC-V 与操作系统的形式化语义、项目新建而此前未公开的可信组件、不需要补丁的完整证明,以及其他未能完成证明的测试要求。Theorem 是 2025 年 Y Combinator 春季批次孵化的公司,自称 AI 与程序语言研究实验室,两位联合创始人都在原文作者名单里。原文链接了它的一份路线图,计划按依赖关系逐步验证整个 Nix 软件生态,其中包括 glibc、OpenSSL、cURL 这些关键基础设施。原文的思路是:在二进制层面用通用的要求工作,不必用另一种语言重写整个代码库;证明可以按软件包复用,每个依赖只需验证一次;依赖关系服从幂律,证明一小批共享库,就能让一大片软件变得可以证明。
Wallach 把这项工作和 Kaashoek、Zeldovich 此前用 agent 验证 xv6 操作系统的技术报告作了对比(Zeldovich 两边都署名):那次是先精心设计一套逻辑(MachCSL),再借大模型用它做验证;这次的自动化程度高得多,agent 自己想出了逻辑,一群 agent 自发地共享思路和技巧,帮助证明推进。他还指出,这些库本来就在 OSS-Fuzz 里,测试入口早已定义好,而任何基于性质的测试都可以改写成定理交给证明检查器。
Wallach 提到的工具包括 Rust 生态中的 Verus、Aeneas,以及支持相关验证方式的 C 工具 Frama-C。他建议把函数调用前需要满足的条件、调用后应保证的结果写回源代码,用这些工具支持后续开发。
他仍希望保留一直到机器码的证明,并近似转述了形式化验证研究者的看法:如果编译器本身已经被证明正确,从中提取关于其输出正确性的证明就更直接;编译器未经证明时,这件事更难。他把对 gcc 或 clang 投入模型算力列为建议,而不是已经完成的研究结果。
anthropic.com · 2026-10-22 · Frontier Red Team 与 Theorem。事件、数字、方法、bug 例子、局限一节与 7 条脚注。
合作方证明仓。公开 60 个入口 / 25 个库、Rocq 9.2.0、构建方式、内存预算、「What a proof does not say」、20,164 条陈述的统计。
莱斯大学计算机科学教授,研究计算机安全 · 2026-10-23。外部评价:一次性挖 bug 的价值、维护与 CI/CD 的担忧、写回源代码的建议。